
Benchmark Akurasi Transkrip Bahasa Indonesia
Seberapa akurat AI menyalin ucapan Bahasa Indonesia, dan berapa biayanya per jam audio? Kami mengukur 8 konfigurasi transkripsi — termasuk pipeline yang benar-benar memproses notulen pelanggan Se-Hari — pada 2,41 jam audio publik berlisensi terbuka. Audio ujinya publik dan hasil per sesi bisa diunduh, jadi angkanya bisa diperiksa ulang.
Temuan utama
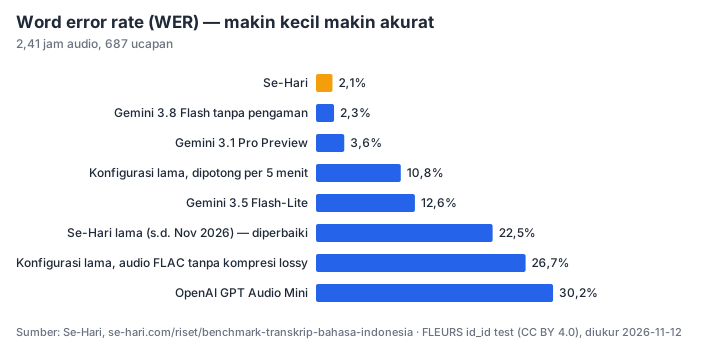
- WER terendah: 2,1% Se-Hari (pipeline produksi: Gemini 3.8 Flash, Opus 16 kbps, segmen 15 menit + pengaman transkrip terpotong). Artinya sekitar 2 dari setiap 100 kata acuan salah, hilang, atau tersisip.
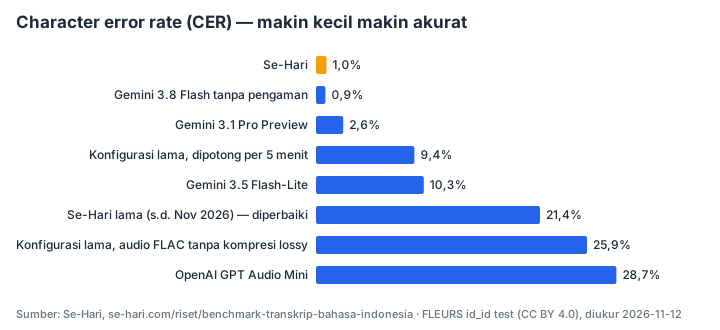
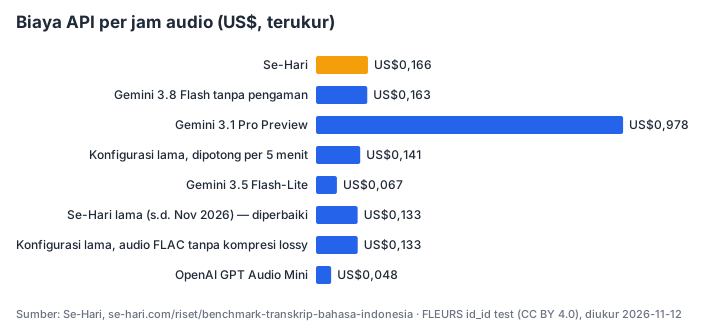
- Pipeline Se-Hari: WER 2,1%, CER 1,0% Peringkat 1 dari 8 konfigurasi yang diuji, dengan biaya API terukur US$0,166 per jam audio. 0 dari 10 sesi keluarannya kurang dari 80% jumlah kata acuan.
- Koreksi: konfigurasi lama kami kehilangan isi — WER 22,5% Pada 4 dari 10 sesi, pipeline yang memproses notulen pelanggan sampai November 2026 hanya mengembalikan sekitar separuh ucapan atau tidak sama sekali, tanpa pesan error. Sudah diperbaiki; rinciannya di bagian koreksi.
- Biaya API: US$0,048–US$0,978 per jam audio Termurah OpenAI GPT Audio Mini (API, prompt Se-Hari); termahal Gemini 3.1 Pro Preview (API, prompt Se-Hari). Diukur dari tagihan sebenarnya per request, bukan dihitung dari daftar harga.
Diukur 12 November 2026. Mengutip? Cantumkan "Se-Hari, Benchmark Akurasi Transkrip Bahasa Indonesia (12 November 2026)" dan tautkan ke halaman ini. Unduh hasil per sesi (CSV).
Hasil lengkap
| Mesin | WER | CER | Substitusi / hilang / sisip | WER sesi terbaik–terburuk | Biaya API per jam audio | Waktu proses ÷ durasi audio |
|---|---|---|---|---|---|---|
| Se-Hari (pipeline produksi: Gemini 3.8 Flash, Opus 16 kbps, segmen 15 menit + pengaman transkrip terpotong) | 2,1% | 1,0% | 171 / 59 / 54 | 1,6%–3,0% | US$0,166 | 0,04× |
| Gemini 3.8 Flash tanpa pengaman (API, prompt Se-Hari) | 2,3% | 0,9% | 196 / 50 / 61 | 1,1%–3,3% | US$0,163 | 0,04× |
| Gemini 3.1 Pro Preview (API, prompt Se-Hari) | 3,6% | 2,6% | 195 / 87 / 205 | 1,3%–9,6% | US$0,978 | 0,15× |
| Konfigurasi lama, dipotong per 5 menit | 10,8% | 9,4% | 202 / 1.179 / 85 | 2,5%–20,6% | US$0,141 | 0,03× |
| Gemini 3.5 Flash-Lite (API, prompt Se-Hari) 1 sesi keluarannya < 80% jumlah kata acuan 1 sesi gagal format JSON (dihitung sebagai transkrip kosong) | 12,6% | 10,3% | 306 / 1.342 / 59 | 2,2%–100,0% | US$0,067 | 0,02× |
| Se-Hari, konfigurasi lama s.d. November 2026 — sudah diperbaiki (Gemini 3 Flash Preview, segmen 15 menit) 4 sesi keluarannya < 80% jumlah kata acuan | 22,5% | 21,4% | 167 / 2.858 / 25 | 0,9%–55,9% | US$0,133 | 0,02× |
| Konfigurasi lama, audio FLAC tanpa kompresi lossy 4 sesi keluarannya < 80% jumlah kata acuan | 26,7% | 25,9% | 149 / 3.435 / 31 | 0,6%–100,0% | US$0,133 | 0,02× |
| OpenAI GPT Audio Mini (API, prompt Se-Hari) 7 sesi keluarannya < 80% jumlah kata acuan | 30,2% | 28,7% | 242 / 3.719 / 131 | 8,3%–57,3% | US$0,048 | 0,03× |
WER/CER dihitung atas seluruh 13.560 kata acuan (bukan rata-rata per sesi). Waktu proses API mencakup antrean dan jaringan; waktu Whisper diukur di server bersama yang sedang sibuk, jadi anggap sebagai batas atas.
Koreksi: yang benchmark ini temukan di pipeline kami sendiri
Pengukuran pertama benchmark ini menjalankan konfigurasi yang saat itu memproses notulen pelanggan (dipakai sampai November 2026): model Gemini 3 Flash Preview, segmen 15 menit. Hasilnya WER 22,5%. Penyebabnya bukan salah dengar. Pada 4 dari 10 sesi, model mengembalikan transkrip yang rapi tetapi hanya berisi sekitar separuh ucapan, atau kosong, tanpa satu pun pesan error — 2.858 dari 13.560 kata acuan hilang. Pemeriksaan kualitas kami hanya menolak transkrip yang terlalu pendek secara mutlak atau bukan bahasa manusia, jadi transkrip separuh seperti itu lolos, diringkas, dan ditagih.
Yang kami ubah:
- Model diganti ke Gemini 3.8 Flash. Pada audio, prompt, dan request yang sama: WER 2,1%, 0 sesi kurang dari 80% kata acuan. Biaya API naik dari US$0,133 ke US$0,166 per jam audio; harga ke pengguna tidak berubah.
- Pengaman transkrip terpotong. Jumlah kata tiap segmen kini dibandingkan dengan lamanya audio bersuara di segmen itu (jeda dan hening tidak dihitung, jadi rapat yang banyak diamnya tidak dihukum). Segmen yang terlalu sedikit katanya ditranskrip ulang dengan potongan lebih pendek; bila tetap terpotong, notulennya tidak diterbitkan dan tidak ditagih. Pada pengukuran ulang ini, 0 dari 10 sesi memicu ulangan dan 0 ditolak.
Baris konfigurasi lama tetap kami tampilkan di semua tabel dan grafik, berlabel. Menghapusnya akan membuat angka kami tampak lebih baik daripada yang pernah dialami pelanggan.
Biaya API vs harga ke pengguna
Kolom biaya di atas adalah ongkos API mentah untuk transkripsi saja. Harga Notulen AI Se-Hari ke pengguna adalah Rp3.000 per jam rekaman (20 menit = 1 kredit = Rp1.000), dan mencakup transkrip bertanda waktu, ringkasan, keputusan, dan action item. Untuk menghitung biaya Anda sendiri, lihat perbandingan biaya notulen AI per jam.
Yang tidak diuji — dan kenapa tidak ada angkanya
Kami hanya memberi angka untuk mesin yang benar-benar kami jalankan. Layanan berikut tidak diuji:
| Layanan | Alasan tidak diuji |
|---|---|
| Otter.ai | Kami tidak punya akun maupun akses API untuk mengunggah berkas uji, dan tidak mendaftar layanan berbayar baru untuk uji ini. |
| Fireflies.ai | Butuh akun dan paket berbayar untuk API unggah; kami tidak mendaftar layanan berbayar baru untuk uji ini. |
| Transkrip bawaan Zoom (VTT) | Hanya dibuat untuk rekaman cloud Zoom sendiri; berkas audio uji tidak bisa dimasukkan, dan Bahasa Indonesia tidak ada di daftar bahasa resminya. |
| Google Cloud Speech-to-Text, Azure Speech, AWS Transcribe, Deepgram, AssemblyAI | Kami tidak punya kredensial untuk layanan ini dan tidak mendaftar layanan berbayar baru. |
| Whisper lokal (small, large-v3, large-v3-turbo; faster-whisper di CPU) | Server uji kami adalah VPS bersama 12 vCPU tanpa GPU yang sedang sibuk (beban rata-rata sekitar 40). Model terkecil yang dicoba (small) belum menyelesaikan satu sesi 15 menit setelah 77 menit waktu CPU, sehingga pengukuran dihentikan. Hasil yang tidak lengkap tidak kami beri angka; model large jauh lebih berat lagi. |
| Mistral Voxtral Small 24B (lewat OpenRouter) | Permintaan ditolak penyedia hulu dengan HTTP 429 (rate limit) pada dua percobaan di hari pengukuran. |
| Mozilla Common Voice (id) sebagai dataset kedua | Unduhan kini mensyaratkan pendaftaran akun di Mozilla Data Collective; uji ini memakai FLEURS saja. |
Metodologi
Audio uji
- Dataset: FLEURS (Google, Conneau dkk., 2022), konfigurasi
id_id, split test lengkap: 687 ucapan, 2,41 jam (termasuk jeda hening 0,5 detik antarucapan; biaya per jam dihitung atas durasi ini). Lisensi CC BY 4.0. - Penyusunan: ucapan disambung berurutan (urutan berkas TSV resmi) dengan jeda hening 0,5 detik
menjadi 10 sesi maksimal 15 menit — sama dengan panjang segmen yang dipakai pipeline
produksi kami. Transkrip acuan = kolom
raw transcriptionFLEURS. - Batasan penting: FLEURS berisi kalimat Wikipedia yang dibacakan satu orang dengan mikrofon cukup baik. Ini bukan rapat: tidak ada suara tumpang tindih, campur kode, atau istilah internal. Angka di sini adalah batas atas kualitas; rekaman rapat sungguhan hampir pasti lebih buruk. Cara menguji dengan rekaman Anda sendiri ada di panduan uji akurasi transkrip.
Konfigurasi yang diukur
- Se-Hari (pipeline produksi: Gemini 3.8 Flash, Opus 16 kbps, segmen 15 menit + pengaman transkrip terpotong) — Dijalankan dengan kode produksi itu sendiri — prompt, body request, parser, dan pengaman terpotong diimpor dari modul yang memproses notulen pelanggan, bukan disalin.
- Gemini 3.8 Flash tanpa pengaman (API, prompt Se-Hari) — Model yang sama dengan produksi sekarang, satu request per sesi tanpa pengaman terpotong — pengukuran awal yang menjadi dasar penggantian model.
- Gemini 3.1 Pro Preview (API, prompt Se-Hari) — Model kelas Pro.
- Konfigurasi lama, dipotong per 5 menit — Model & audio lama, tetapi segmen 5 menit alih-alih 15 menit.
- Gemini 3.5 Flash-Lite (API, prompt Se-Hari) — Varian termurah keluarga Gemini dengan input audio.
- Se-Hari, konfigurasi lama s.d. November 2026 — sudah diperbaiki (Gemini 3 Flash Preview, segmen 15 menit) — Konfigurasi yang memproses notulen pelanggan sampai perbaikan ini. Pada sebagian sesi ia mengembalikan hanya sekitar separuh ucapan — atau tidak sama sekali — tanpa pesan error, dan hasil seperti itu lolos pemeriksaan kami lalu ditagih. Kami menemukannya lewat benchmark ini, lalu mengganti model dan memasang pengaman (lihat bagian koreksi).
- Konfigurasi lama, audio FLAC tanpa kompresi lossy — Model lama dengan audio lossless: mengukur apakah kompresi Opus 16 kbps penyebab kata yang hilang (ternyata bukan).
- OpenAI GPT Audio Mini (API, prompt Se-Hari) — Audio Opus yang sama, didekode lalu dikirim sebagai MP3 64 kbps (API ini hanya menerima wav/mp3).
Semua model API menerima prompt yang sama persis dengan produksi (diambil langsung dari kode sumber saat skrip berjalan) dan audio yang sama. Model lewat API dipanggil melalui OpenRouter; biaya diambil dari kolom biaya yang dilaporkan per request. Total biaya API seluruh pengukuran: US$4,44.
Penilaian
- Normalisasi (sama untuk acuan dan keluaran mesin): huruf kecil, tanda hubung jadi spasi ("orang-orang" = "orang orang"), tanda baca dibuang, spasi dirapikan. Angka tidak dinormalisasi: "20" vs "dua puluh" dihitung salah.
- WER = (substitusi + penghapusan + penyisipan) ÷ jumlah kata acuan, dihitung atas seluruh korpus
dengan pustaka
jiwer. CER = hal yang sama pada tingkat karakter. - Keluaran yang gagal di-parse sebagai JSON dihitung sebagai transkrip kosong — sama seperti di produksi, di mana keluaran rusak menggagalkan notulen.
- Diarisasi (siapa bicara), tanda waktu, dan kualitas ringkasan tidak dinilai di benchmark ini.
Skrip pengukuran kami simpan dan jalankan ulang untuk setiap pembaruan; untuk verifikasi independen silakan hubungi kami lewat halaman kontak. Pengukuran berjalan 12 November 2026–12 November 2026.
Ingin melihat hasilnya pada rekaman rapat Anda sendiri? Unggah rekaman atau sambungkan rekaman Zoom ke Notulen AI Se-Hari — satu jam rekaman Rp3.000, tanpa langganan. Rapatnya belum ada? Sewa Zoom harian dengan cloud recording, lihat daftar harga.
Lisensi hasil & grafik: CC BY 4.0. Riset lain: pola meeting online Indonesia.